产品更新 / 本地模型 · 语音交互
Liquid AI 发布 LFM3-Omni-2B,支持本地画面理解与语音对话
10 月 27 日发布的开放权重模型可结合画面与音频输入,输出文字或语音,为本地 NPC 对话原型提供基础;游戏侧仍需完成集成。
希望为原型加入语音 NPC,或让助手结合提供的游戏画面回答语音问题的开发者。
Liquid AI 于 10 月 27 日随 LFM3 家族发布 LFM3-Omni-2B。这个开放权重模型接受文字、图像、视频和音频输入,可以用文字或语音回答。对游戏开发者而言,它为本地语音对话原型提供了基础,例如让 NPC 结合提供的场景图片回应玩家的语音问题;游戏侧仍需自行完成集成。
在一个模型中结合画面与语音
发布公告将 Omni 介绍为 Liquid 首个融合视觉、音频与语言的模型。能力指南演示了对图片提语音问题、结合视频与声轨问答,以及交错输出文字和语音。仅处理语音时,同次发布还有 LFM3-Audio-2B。
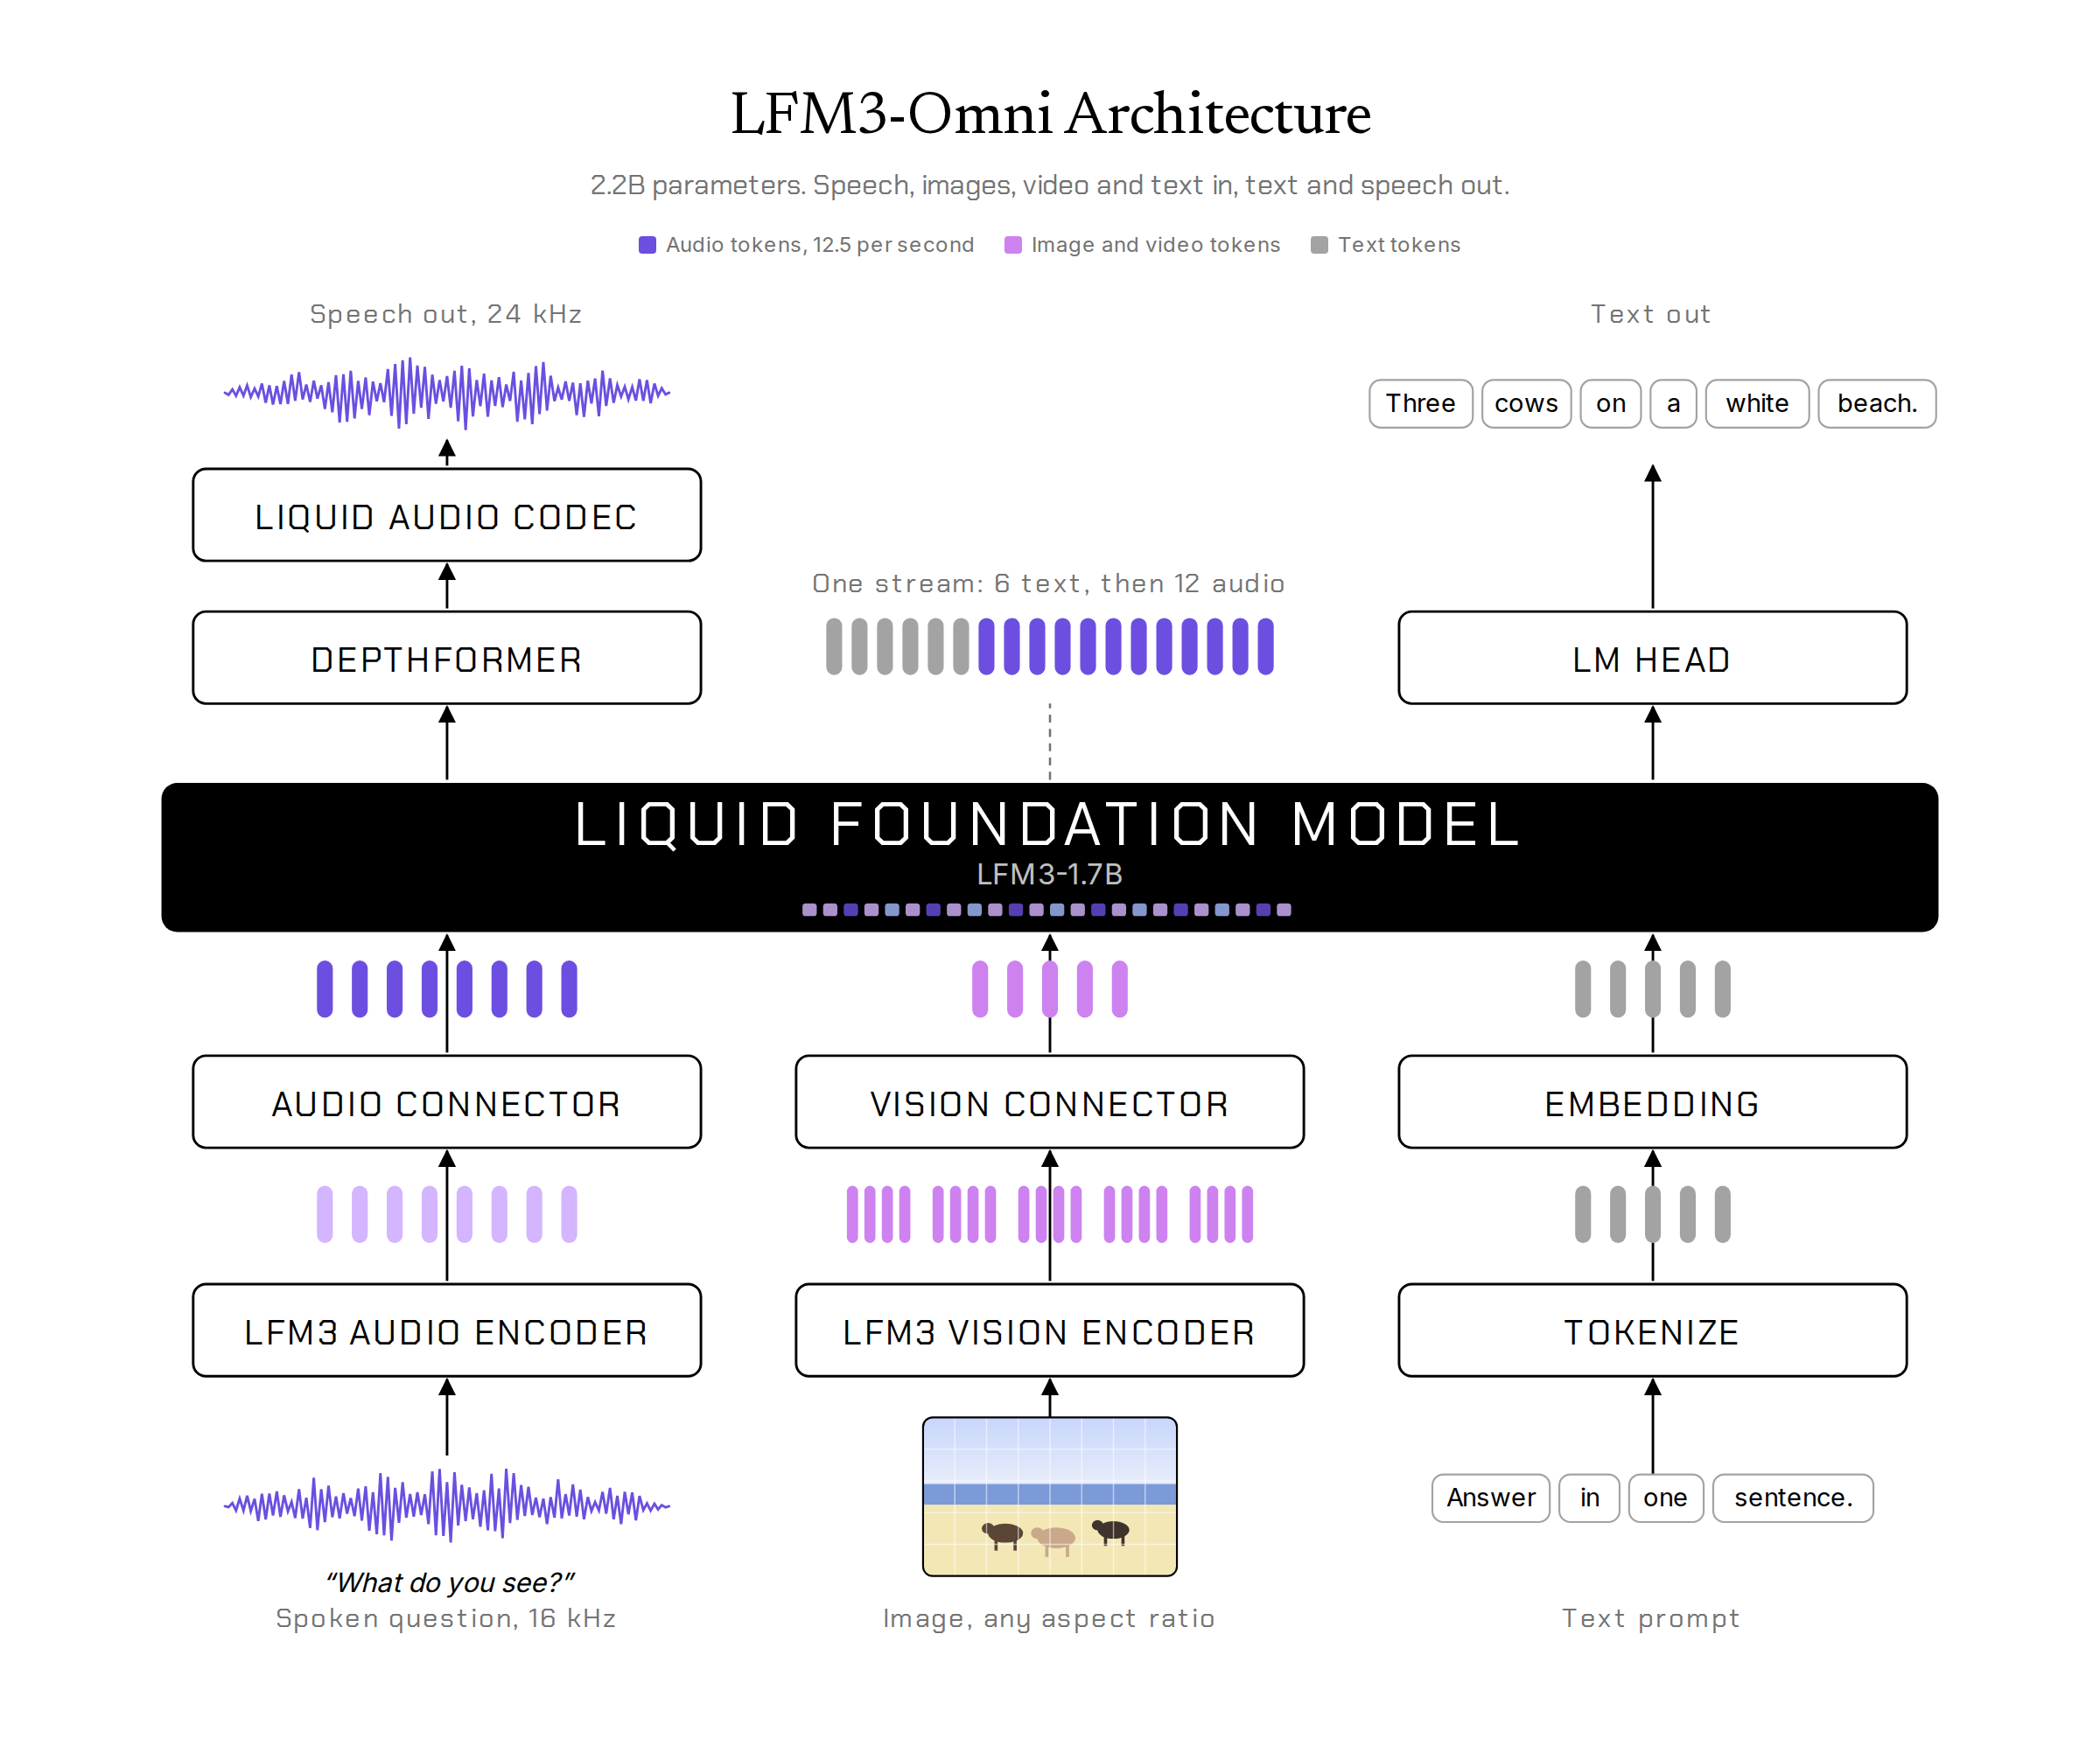
模型卡列出 21.7 亿参数和 32K token 上下文窗口。BF16 权重面向 GPU 推理,GGUF 提供本地 CPU / GPU 运行路径,包括实时语音服务器。不同运行框架的支持范围有差别,例如模型卡列出的 SGLang 路径只输出文字。
模型还可以结合语音请求和视觉信息提出工具调用,由应用解析、执行并回传结果。原型可以把这套机制连接到少量游戏动作,并以图片提供当前场景;目标设备上的延迟和对话一致性仍需验证。
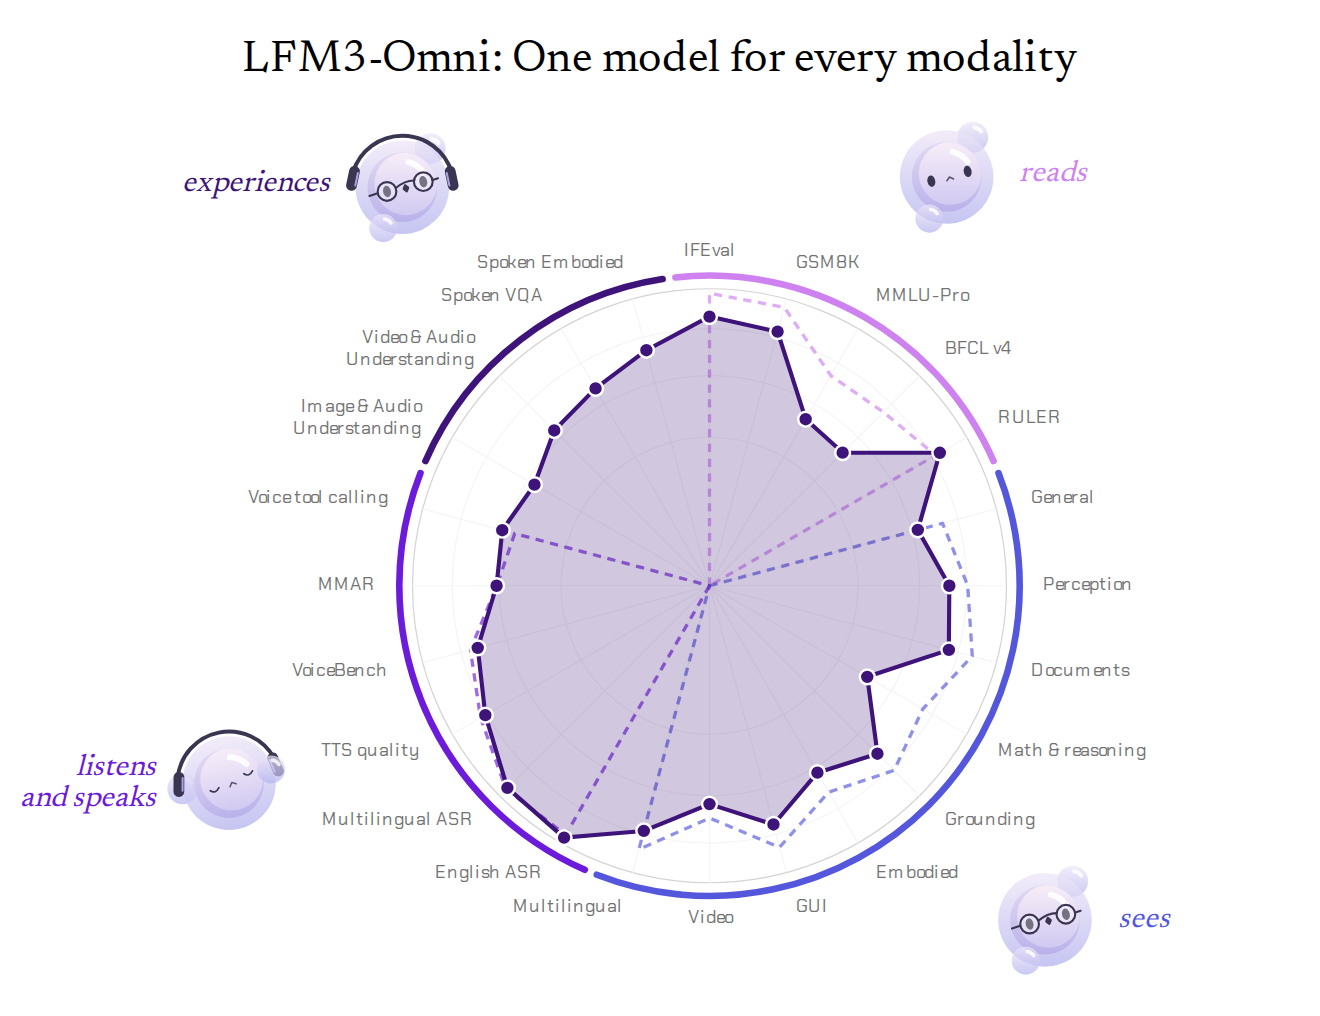
图中汇总的是 Liquid AI 自己进行的多模态基准测试,不能据此认定运行中游戏的表现。相关制作工具可继续查看叙事与 NPC 分类。
本地许可与托管 API 分别计费
本地部署遵循 LFM Open License。Liquid 的价格页将年营收低于 1000 万美元的企业列入开放权重免费档,更大企业需购买许可;本地硬件和运行成本仍由开发者承担。
托管 Omni API 另按用量计费。目前每百万 token 的文字输入 / 输出为 0.10 / 1 美元,音频输入 / 输出为 2 / 10 美元。这些是不同模态的 token 单价,不能直接当作 NPC 对话每分钟的费用。
参考来源 (5)
依据官方公告、模型卡与公开文档整理,无赞助或联盟链接。