产品更新 / AI NPC · 本地推理
Atelico AI Engine 开放抢先体验,在玩家设备上运行 NPC 对话
10 月 29 日开放的有限抢先体验,将本地 AI 推理、台词检索和角色状态控制带入游戏运行时。SDK 仍需申请,GPU 性能数字来自厂商限定条件的测试。
接入本地 NPC AI 时,要一起规划台词规则、角色状态、渲染时间与模型内存。
Studio Atelico 于 10 月 29 日宣布 Atelico AI Engine 开放有限抢先体验,SDK 仍需申请。这个运行时把语言模型、语音、图像生成和 NPC 行为系统放到玩家设备本地运行。对制作对话或交互叙事的团队,重点是将推理、预写台词和角色状态组织进同一个游戏项目。官方公告保留了抢先体验的申请入口。
引擎集成说明列出 Godot 4 GDExtension、Unity C# 绑定,以及支持 Blueprint 的 Unreal Engine 5 subsystem。Unity 文档明确覆盖 Windows、macOS 和 Linux 独立构建;这份集成方向说明不代表 SDK 已面向所有开发者开放下载。
按语义找台词,用状态约束对话
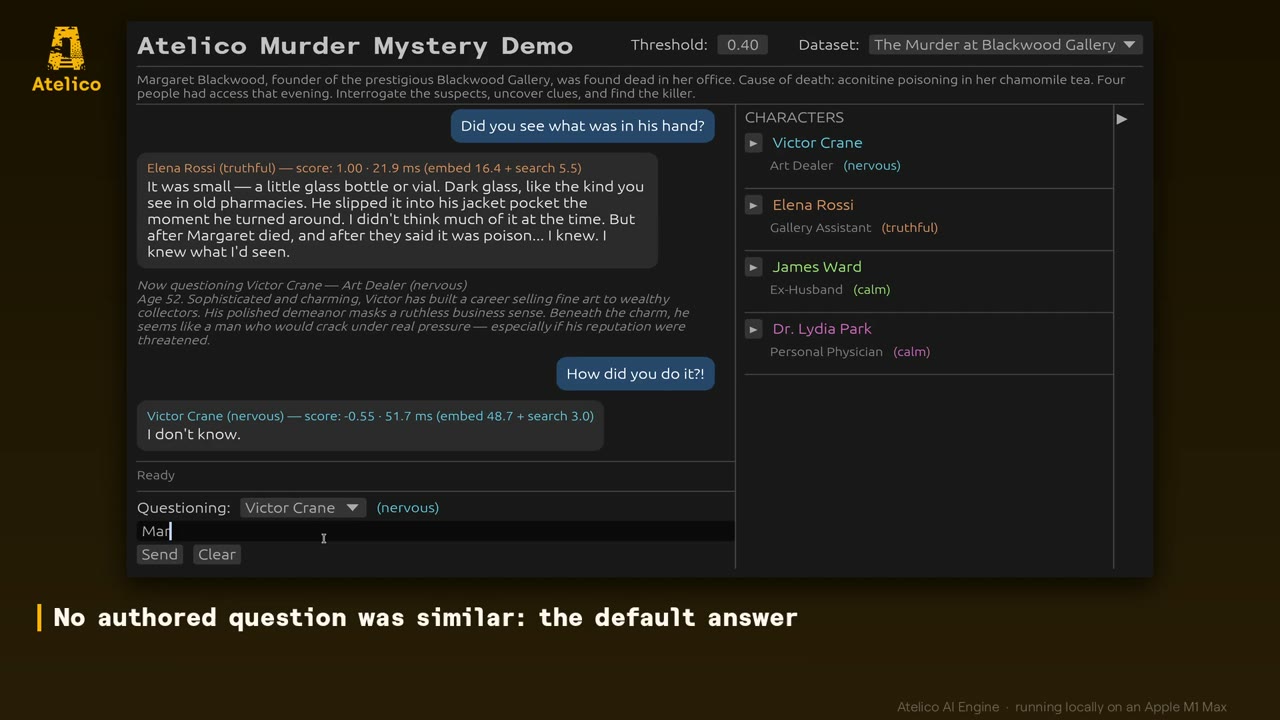
创作控制文档支持给预写台词附上元数据,再按玩家问话的语义检索。角色状态可限定当前能使用的回应;需要生成内容时,可以用选项列表、JSON Schema 或语法约束组织输出,并配置过滤与重写规则。
例如,推理游戏可以接受自由输入的问题,同时让嫌疑人的回答受设计好的情绪状态约束。台词、状态切换和无法匹配时的回应,仍需由开发者围绕具体剧情设计。官方审讯演示展示了这条内容编排路径。
把推理预算放进 GPU 调度
Atelico 的 Compute Graphics Scheduler 在推理与渲染之间分配 GPU 时间。集成接口提供渲染优先、平衡与计算优先三种模式。
厂商基准表列出的条件是 RTX 5080、4K 的 San Miguel 场景及 Llama 3.2 3B 推理负载:仅运行游戏的基线为 123 FPS,Balance 模式为 121 FPS。图中 3 FPS 对照来自自家引擎在独立 CUDA 上下文中的运行,不能归为所有其他推理工具的表现。
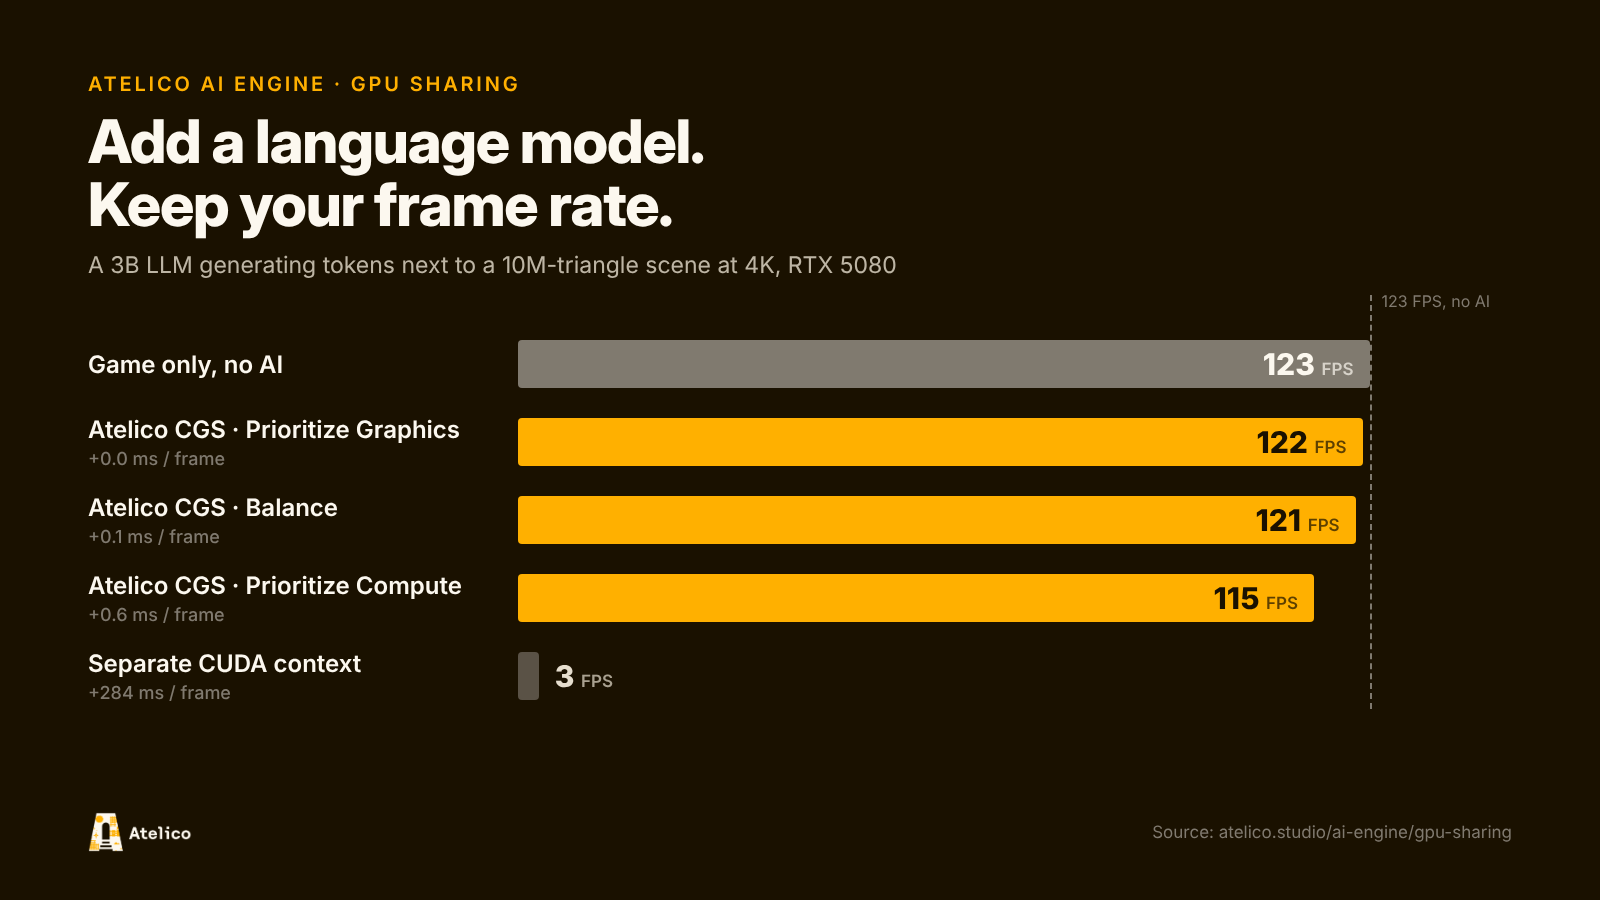
这些数字是特定硬件、场景和模型下的厂商测量,不能直接换成其他游戏的帧率保证。基准页还列出不同模型的内存估计,接入时要给渲染、模型权重和上下文缓存一起留出预算。
本地推理可避免逐次云端推理费用,但本次公告没有公布 SDK 许可价格,不能据此认为 SDK 免费。准备搭建剧情对话原型的开发者,可以从站内叙事、对话与 NPC 分类继续比较相关工具。
参考来源 (5)
本文无赞助或联盟链接。