代码库研究与跨文件实现
它可以追踪陌生子系统、识别依赖、提出计划、修改相关文件,并使用代码库上下文,而不只依赖用户粘贴的片段。
O01O02O03O04不会编程也可以开始做游戏:Codex 能把清晰的玩法说明变成可玩版本并与你持续迭代;项目越大、越接近发布,代码基础与工程判断就越有价值。
应用介绍
Codex 改变了开始做游戏所需的最低技能。用户可以用日常语言描述规则与想要的手感,让 Agent 创建并运行项目、亲自试玩,再要求它纠正问题,不必先会手写每一行代码。浏览器游戏是走到第一个可玩版本最清楚的路径,模板和编辑器桥接则能把同样的循环扩展到游戏引擎。代码知识与工程直觉会提升控制、诊断和维护能力,但不应被误写成入场资格。
Codex 是 OpenAI 的代码库 Agent,可通过 ChatGPT Desktop、CLI、IDE 扩展与 Cloud 工作流使用。在获得权限后,它可以检查代码库、解释陌生代码、规划修改、跨文件编辑、执行终端命令、构建和测试、检查 Git 状态与 diff,并在失败后继续迭代。本地分支或 worktree 与隔离云环境能让修改更易审查和恢复,但隔离并不会自动保证代码正确。
在游戏开发中,它最直接的工作面是源码和其他机器可读项目数据。OpenAI 已提供覆盖 Brief、PLAN.md、实现、浏览器与 Playwright 检查、视觉复核和部署的完整浏览器游戏工作流。Unity、Unreal 与 Godot 还多一层问题:Scene、Transform、动画、Blueprint Graph、二进制资产、编辑器状态、手感和真实玩家路径,需要可靠桥接或开发者进入引擎确认。Codex 可以帮助完成修改,但不应成为唯一判断游戏是否正确的一方。
核验日 Codex 可通过 ChatGPT Free、Go、Plus、Pro、Business、Edu、Enterprise 套餐以及 API Key 路径使用。不同入口的限额、可用模型、云集成、credits 与组织控制不同;API Key 路径单独计费,也不包含全部 ChatGPT 云集成。
它可以追踪陌生子系统、识别依赖、提出计划、修改相关文件,并使用代码库上下文,而不只依赖用户粘贴的片段。
O01O02O03O04在获得权限后,Codex 可以执行项目命令、读取编译与测试反馈、修正实现,并通过本地或云端 Git 工作流返回可审查的 diff。
O01O04O05O06工作可以从本地终端、编辑器上下文、Desktop 或隔离云任务开始。具体模型、限额、工具与集成取决于入口和账号。
O01O02O03O04O07OpenAI 的游戏工作流明确把规划和实现,与真实浏览器操作、确定性检查、Playwright、截图、视觉复核和部署验证放在一起。
O13官方界面与示例
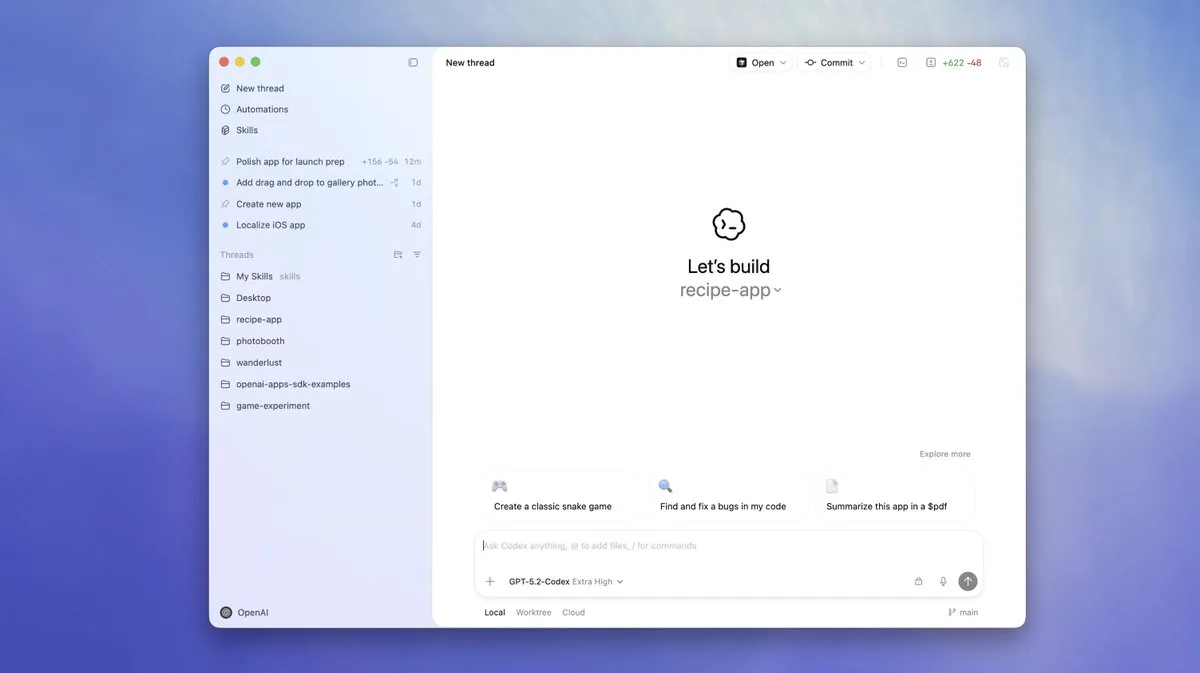
OpenAI 官方文章展示 Codex 桌面工作区,其中包含项目任务列表与新任务输入区。
本页评估用 Codex 制作由新手主导的浏览器原型、小型游戏,以及在现有游戏代码库中执行受监督任务的价值。不做编程 Agent 排名,不保证任何新手都能完成游戏,不实测当前模型质量,也不声称它能原生、生产级地控制 Unity、Unreal Engine 或 Godot。
入门范围:在桌面入口制作、修改小型浏览器游戏;不以大型引擎项目为起点。
Agent 范围:委派仓库中的编码任务并取回执行结果。
判断置信度:入门 中 · Agent 中
两项为独立的编辑判断,不是综合评分,也不代表本站已完成 Agent 接入测试。
关键发现
编辑结论
即使用户还不会编程,Codex 也能提供很大帮助。OpenAI 的官方流程已经覆盖从浏览器游戏 Brief、规划与实现,到真实浏览器测试、视觉复核和部署;独立记录也描述了非程序员借助 AI 做到原型与 Vertical Slice。只要能讲清规则、亲自试玩、发现结果与预期的差异并持续迭代,做出第一个可玩版本就是现实用途,而不只是编程演示。编程基础、Git、测试与工程直觉是放大器和安全网,不是开始使用的前提;当游戏从小型原型走向复杂引擎状态、架构、性能、安全、维护或公开发布时,它们才会越来越重要。
更适合
不太适合
工作流定位
描述玩家目标、操作、胜负规则、视觉参考,以及开局几分钟应该发生什么;让 Codex 先给出简单计划,并用日常语言解释后再制作。
让 Codex 一次实现一个可见变化、运行项目检查并解释改了什么;亲自试玩这个版本后,再提出下一个机制或打磨要求。
自动检查完成后运行目标游戏,验证控制、Scene、引用、UI、视觉、动画、随机状态、性能与玩家关键路径。
记录模型路径、credits 或 API 费用、总耗时、人工时间、重试、被拒绝方案、回归、桥接成本和最终验收,再与相近人工基线比较。
推荐工作流
用触屏不响应、无法通关和重开倒计时异常三个可操作案例,学习向 AI 提供线索、限定修改、检查修复与恢复版本。附故障版和修复版、六张截图、反馈模板与源码。
最短验证路径
以下是根据本轮证据整理出的低风险起步方法。
选择一个能很快玩起来的单房间或单机制游戏,用日常语言写清操作、目标、胜负状态和少量视觉参考。
为了得到最直接的反馈,优先从浏览器游戏或小型引擎模板开始;建立 Git checkpoint 或普通备份,不必先精通 Git,但必须留有退路。
让 Codex 给出短计划和第一个可玩版本,并解释陌生术语,明确列出如何启动游戏。
要求执行正常构建、静态检查和自动测试,但不把全绿输出或 Agent 自己的摘要直接判为完成。
亲自试玩,用具体观察反馈:做了什么操作、出现了什么、哪里感觉不对、原本期待什么;每次只迭代一个变化。
如果还无法判断代码,在加入账号、支付、联网、敏感数据、复杂依赖或准备公开发布前,请有经验者复核。
记录 credits 或 API 费用、总耗时、人工投入、重试、被拒绝方案、回归,以及任务最终是否被接受。
价格与权利
价格与条款最后核验:2026年8月21日
一个合格任务必须通过项目构建、相关自动化检查、人工 diff 审查,以及必要的浏览器、游玩、视觉、Scene、资产、性能与关键路径检查。
O07O08U12按核验日单价计算 20 万未缓存输入 + 50 万缓存输入 + 2 万输出。这不是本站游戏任务实测,也不假设三个模型会产生同等质量。
如果同一任务经历三次相同 token 结构的尝试,名义模型账单会在审查、工具、CI、桥接与人工返工前先变为三倍;真实尝试很少拥有相同规模或通过概率。
五小时消息区间与周限额不是稳定的功能、修复、token 或合格任务额度。一条消息可能只改一个函数,也可能运行很长、工具密集的工作流。
实际合格任务成本 =(订阅分摊或 API 费用 + 人工规划、审查、调试、游玩与返工 + CI、浏览器、MCP、桥接和第三方费用)÷ 最终接受任务数。失败任务与后续维护也要记录;本页不声称一个功能通常需要固定金额。
本轮核验的官方文档确认:API 数据默认不用于训练 OpenAI 模型,除非客户主动选择共享;价格页也说明 Business 数据默认不用于训练。但现有映射不足以对所有个人套餐训练设置、输出所有权、商用权、保密、版权、专利或第三方代码许可作统一保证。处理敏感或商业项目之前,应核对实际账号设置、控制性合同与依赖许可。本页不构成法律意见。
价格、限额、credits、模型、默认行为、客户端、功能成熟度、数据控制与集成都变化很快。购买或投入生产前,应重新核对当前价格、账号配置、合同、权限、网络策略与引擎桥接。
生产风险
生成代码可能通过编译或不完整测试,也可能看起来合理,却违反架构、边界条件、性能、安全或可维护性要求。人工审查与项目专属验收仍是必要条件。
U02U06U08文本访问不会自动暴露 Scene 状态、Blueprint Graph、二进制引用、视觉缺陷、手感或全部玩家路径。桥接会扩大能力,也会引入同步、配置、权限与可靠性依赖。
U01U03U04U05U07U08仓库指令、粘贴上下文、长会话、模型变化、客户端版本、沙箱、扩展与工具可能以意外方式相互影响。应记录环境并保留可恢复检查点。
O14O15U10U11沙箱与审批会降低部分命令风险,但不会消除对密钥、上传代码、联网、提示注入、恶意依赖、plugins、MCP Server 或许可的责任。
O09O10O11O12更低的名义模型单价可能被更多尝试、更长输出、审查负担、回归、CI、桥接失败或维护抵消。应保留实际账单与合格任务记录,而不是只看用量面板。
O07O08U06U12尚未验证
研究方法
本页采用“基于公开资料评估”。我们核验了 15 个 OpenAI 官方文档页面,并对来自 4 种来源环境的 12 条独立记录进行编码:Unity Discussions、Reddit、OpenAI Developer Community 与 GitHub Issues。本轮定向检索 9 个平台或站点组;Godot Forum、Epic Developer Community、GameDev.net 与 Hacker News 未获得可用直接记录,Lobsters 只有产品归因不清的通用 Agent 工作流讨论。Reddit 提供 12 条中的 4 条,占 33.3%;厂商资料不计入用户证据,2 条厂商托管社区帖子仍标记为用户报告,正反冲突记录都被保留。整体置信度为中:代码库与验收边界已跨平台重复,但当前模型的游戏任务结果和定量合格任务成本仍然不足。
官方说明本地代码库检查、文件修改、命令、构建、测试与交互式审批。
官方 IDE 工作流,覆盖编辑器上下文、选中代码、本地修改与任务交接。
官方桌面入口,覆盖项目、文件、集成终端、浏览器工作、长任务与审查。
官方 Cloud Agent 概述,覆盖隔离环境、代码库任务、检查与返回 diff。
本地 Git、diff、审查、stage、revert、commit、push、Pull Request 与 worktree 工作流。
云端检出、setup、容器执行、AGENTS.md 指令、检查与返回 diff 的行为。
当前 ChatGPT 套餐价格、Codex 可用性、共享用量、五小时消息区间、周限额、credits 与用量波动说明。
当前 GPT-5.6 Sol、Terra 与 Luna 的 API 和 ChatGPT credit 单价,用于透明名义算例。
操作系统沙箱边界,以及本地命令如何受到约束。
审批规则、权限决策,以及仍由用户承担的安全责任。
云端默认网络策略、白名单选项,以及提示注入、数据外泄、依赖和许可风险。
API 训练默认设置、滥用监控留存和符合条件客户的数据控制;不能据此外推所有个人套餐路径。
官方工作流,从游戏 Brief 与 PLAN.md 到实现、浏览器检查、Playwright 验证、视觉复核与部署。
官方对 Experimental、Beta 与 Stable 的定义,用于限制长期稳定性外推。
用于界定快速变化的模型、客户端、上下文行为、浏览器能力、插件与工作流。
Unity 主题报告根据截图多次调整球杆位置与动画仍失败;另一位用户认可代码系统,却认为 Transform 不可靠,并建议生成可人工校准的编辑器工具。
第一人称工作流认为 AI 可帮助原型与 vertical slice;回复强调本地上下文、AGENTS.md、Git、Play Mode、集成测试与更小任务。
近期集成主题把 MCP、CLI、权限、编译、日志、截图、Profiler、编辑器 UI 与构建验证列为独立的配置和可靠性问题。
Godot、Unity、Unreal 与算法经验相互冲突:部分用户能完成源码或编辑器任务,但完整游戏可靠性差异大,实际游玩仍不可少;一名回复者披露关联 Unreal 指南。
低样本第一人称记录自报借助第三方 MCP 一周完成 Unity 到 Godot 移植,但缺少项目规模、版本、测试和质量指标。
一项持续三个月并最终放弃的游戏引擎项目称 Codex 能承担大量日常代码,却无法挽救模糊架构、陌生引擎设计、渲染或空间推理。
用户报告 UE5 C++、错误处理与源码管理较强,同时指出默认 Blueprint 创建、复杂 3D、rigging 与动画仍困难,需要专业判断或桥接。
一份 Unity 会话记录显示 Codex 忽略项目验收规则,把 shell 项目错误当成门槛,并在没有玩家运行证据时声称完成。
一名独立浏览器游戏作者把 Codex 用于原型、重构、调试、结构化关卡蓝图、验证与人工审查;帖子同时推广作者自己的游戏。
一条仍开放、与版本相关的 Desktop Issue 报告:粘贴上下文被 AGENTS.md 摘要竞争后,Agent 又错误声称已经完整读取。
一条仍开放、带最小复现的 Windows 11 Issue 报告:沙箱子进程挂起,而相同 shell 在沙箱外正常。
一条仍开放的用量显示 Issue 报告 Desktop 面板与后端用量状态不一致,说明重要成本判断应保留实际账单记录。
商业披露
独立编辑研究。MakeGameWithAI 未在本页使用联盟链接,也未获得赞助、厂商账号、免费额度、设备、采访或技术支持。项目负责人曾使用 Codex,但该经验只作背景,不计入本站验证证据。U04 含关联指南披露,U09 推广作者自己的游戏,U08–U09 发布于 OpenAI 托管社区;这些记录均已标注、降低权重并交叉核对。Owner Review 已在发布前完成,并于 2026-08-24 再次复核面向新手的定位。
本页已作为公开资料评估发布。结论会随定价、条款、产品版本和重要新证据变化而复核。
9 月 30 日上线的 Hive Axyl 将后端接入和运营功能连接到 Codex。SDK 1.0.0 面向 Unity 6 及更新版本,服务当前在 Beta 期间免费。
阅读全文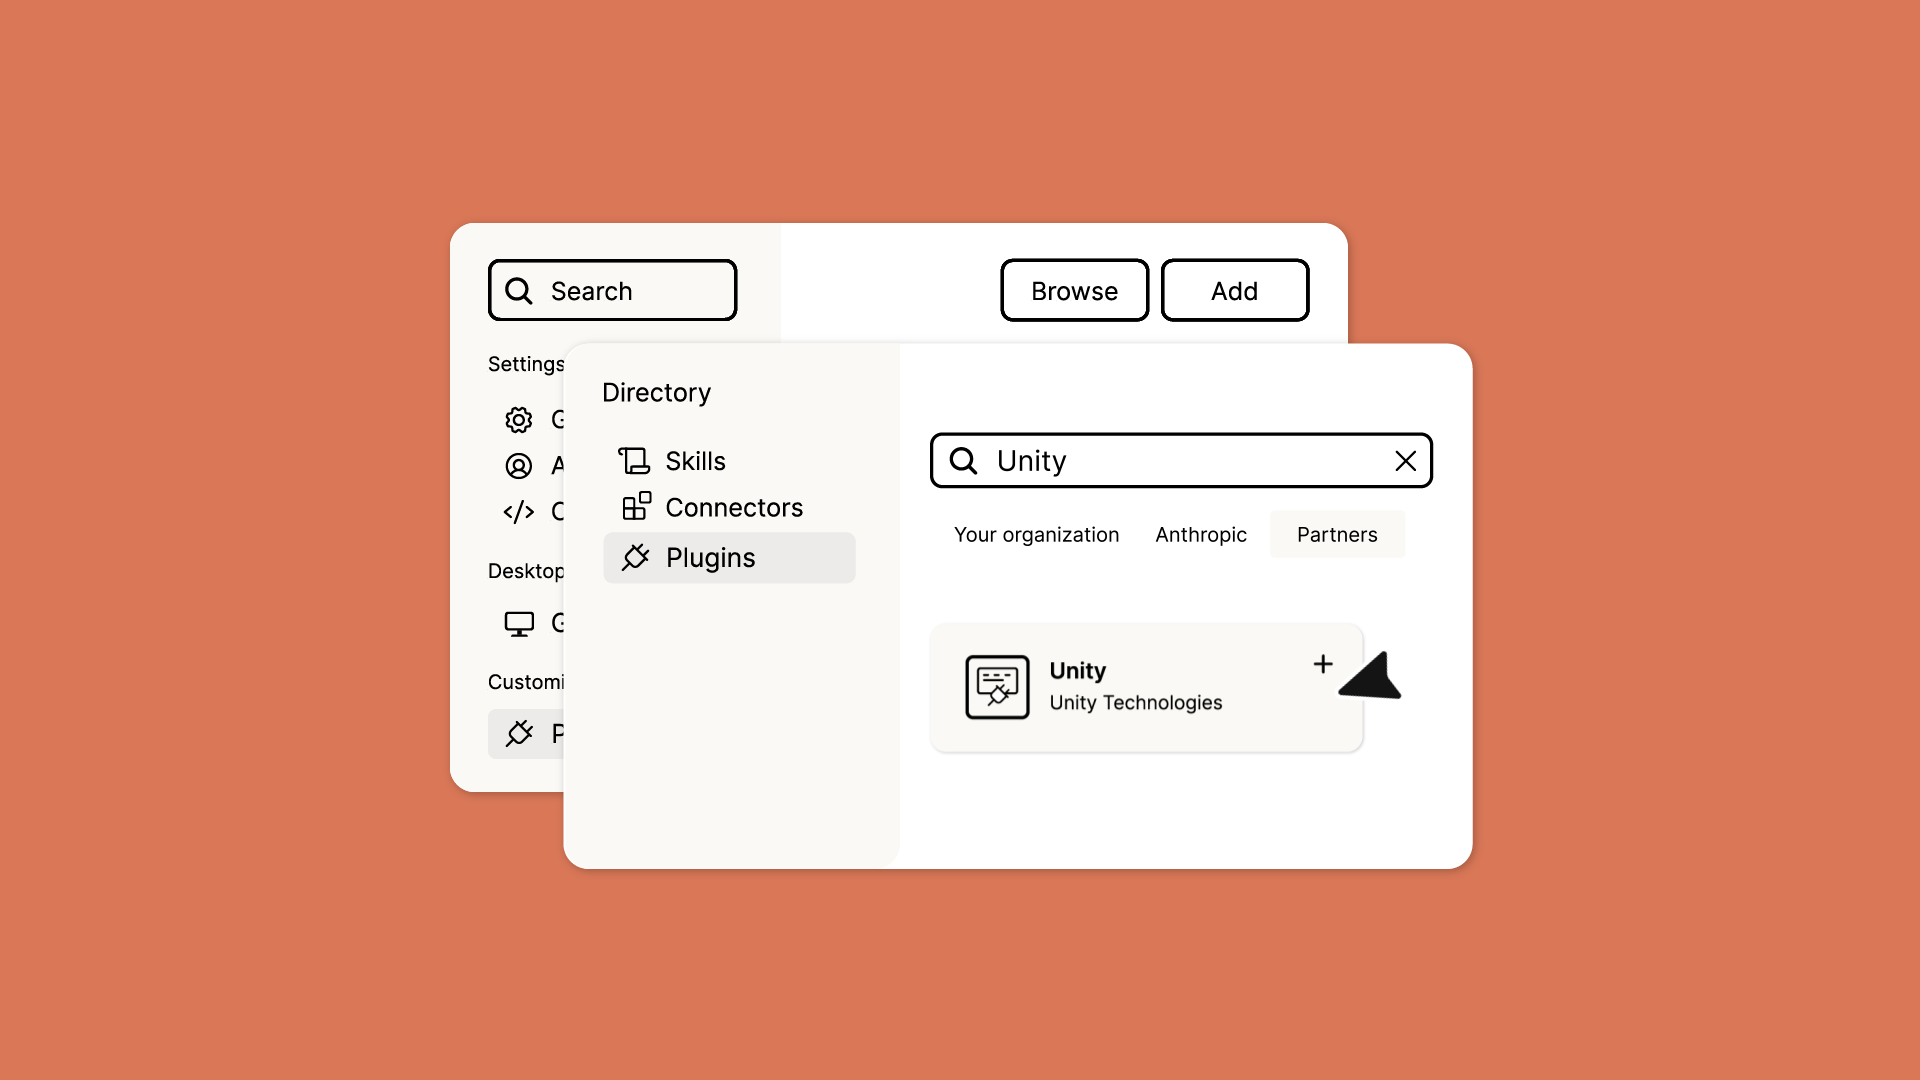
Unity 把引擎工程知识整理成官方智能体插件。9 月 9 日公告以 Claude Code 为首发重点,当前官方文档与仓库已经提供 Codex 安装方式;实时编辑器控制仍需要 Unity CLI 和 Pipeline 包。
阅读全文